Zero-Downtime Deployment: Blue-Green vs Rolling Update, dan Kapan Saya Pakai Keduanya
Strategi zero-downtime deployment blue-green dan rolling update: pengalaman praktis, konfigurasi nyata, dan jebakan migrasi database yang pernah saya alami.
Jam 11 pagi, saya baru selesai deploy rilis besar ke production, dan tiga menit kemudian Slack klien saya penuh: "aplikasi error semua". Bukan karena kodenya salah — rollback dua menit selesai — tapi karena deploy itu mematikan semua container sekaligus selama 15 detik. Lima belas detik saja, dan 200 user aktif langsung merasakannya. Dari situ saya memutuskan: tidak ada lagi deploy yang boleh menyebabkan downtime, bahkan satu detik. Artikel ini adalah rangkuman strategi yang saya pakai sekarang: blue-green, rolling update, dan jebakan yang jarang dibahas orang — migrasi database di tengah deployment.
Kenapa "restart semua container" bukan pilihan
Cara paling naif melakukan deploy adalah: docker compose down && docker compose up -d. Saya pernah melakukan itu bertahun-tahun, dan selamat saja karena aplikasinya internal dengan traffic rendah. Begitu aplikasi menangani traffic publik atau webhook dari pihak ketiga, mati 10–30 detik itu berarti request gagal, koneksi database terputus di tengah transaksi, dan yang paling menyakitkan: webhook partner yang tidak di-retry.
Prinsip dasarnya satu: load balancer atau proxy harus bisa memutus koneksi ke container lama secara bertahap, setelah container baru siap menerima traffic. Dua strategi dominan untuk mencapai itu adalah blue-green dan rolling update. Keduanya menyelesaikan masalah yang sama dengan kompromi yang berbeda.
Blue-green deployment: dua lingkungan, satu switch
Konsepnya sederhana. Anda punya dua lingkungan identik: blue (production aktif) dan green (idle). Versi baru di-deploy ke green, di-smoke test, lalu proxy diarahkan dari blue ke green. Kalau ada masalah, arahkan kembali ke blue. Rollback-nya nyaris instan karena environment lama masih utuh.
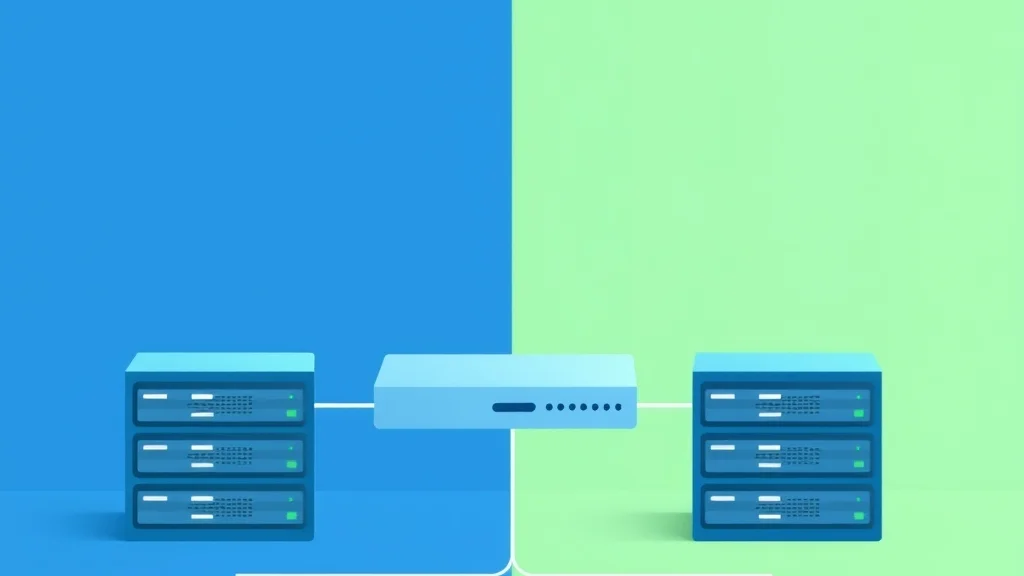
Setup yang saya pakai di salah satu proyek SaaS (Node.js + PostgreSQL, VPS, tanpa Kubernetes) pakai Kamal Proxy — proxy minimal dari Basecamp yang memang didesain untuk zero-downtime deployment. Kamal Proxy menangani bagian tersulit: dia menjalankan container baru di port berbeda, menunggu health check lolos, baru memindahkan traffic di layer socket, sehingga request in-flight tidak terputus.
# Deploy dengan Kamal: build image baru, jalankan container di slot baru, switch traffic
kamal deploy

# Kalau bermasalah, rollback ke version sebelumnya
kamal app rollback
Yang saya suka dari pola ini untuk setup kecil-menengah: kompleksitas operasionalnya rendah. Tidak perlu Kubernetes, cukup satu VPS dan proxy yang benar. Ada juga pendekatan serupa dengan Docker Compose murni — jalankan app_v2 berdampingan dengan app_v1, lalu ubah upstream nginx — yang dibahas cukup detail di artikel Zero-Downtime Deployments with Docker Compose. Saya pernah pakai pola ini sebelum pindah ke Kamal, dan itu bekerja baik selama Anda disiplin dengan health check.
Biaya yang harus Anda sadari
Blue-green butuh resource dua kali lipat saat window deployment. Untuk aplikasi dengan memori 4 GB per instance, berarti VPS Anda harus sanggup menampung 8 GB sesaat. Di proyek dengan budget VPS kecil, ini sering jadi titik gagal — OOM justru terjadi saat deploy, momen yang paling kritis. Solusinya: turunkan memory limit container non-kritis, atau pakai rolling update.
Rolling update: ganti bertahap, hemat resource
Rolling update mengganti instance satu per satu (atau per batch). Docker Swarm dan Kubernetes melakukannya secara native. Di Kubernetes, yang sering diabaikan orang adalah tiga konfigurasi ini di Deployment spec:
spec:
  strategy:
    rollingUpdate:
      maxSurge: 1        # boleh tambah 1 pod di atas replica count
      maxUnavailable: 0  # JANGAN ada pod yang mati sebelum penggantinya siap
  minReadySeconds: 30    # pod baru harus stabil 30 detik sebelum dihitung ready
  terminationGracePeriodSeconds: 45
maxUnavailable: 0 adalah kuncinya. Default Kubernetes sebenarnya 25%, artinya Kubernetes dengan santai mematikan pod lama sebelum pod baru ready — dan itulah sumber downtime "misterius" yang banyak orang tanyakan. Panduan Zero-Downtime Kubernetes Deployments di EKS membahas ini lebih jauh, termasuk kombinasi dengan PodDisruptionBudget supaya node maintenance pun tidak mengganggu service. Satu hal tambahan yang sering terlewat: aplikasi Anda harus menangani SIGTERM dengan benar — berhenti menerima job baru, selesaikan request in-flight, baru exit. Kalau Node.js Anda tidak punya handler SIGTERM, terminationGracePeriodSeconds tidak menyelamatkan apa pun.
Rolling update punya kelemahan struktural
Selama rolling update berlangsung, dua versi aplikasi berjalan bersamaan. Kalau API Anda berubah kontrak (response field di-rename, endpoint dihapus), sebagian user akan kena versi baru dan sebagian versi lama — dalam window yang sama. Untuk perubahan breaking, rolling update aman hanya kalau Anda menjaga kompatibilitas ke belakang selama minimal satu siklus deploy. Ini persis alasan kenapa saya jadi pengguna berat feature flag: pisahkan deploy dari rilis, dan rolling update jadi jauh lebih aman.
Jebakan yang benar-benar merusak: migrasi database
Ini bagian yang jarang dibahas di tutorial, dan justru sumber insiden terburuk saya. Zero-downtime di layer aplikasi tidak ada artinya kalau migrasi database Anda memblokir tabel yang aktif dipakai.
Contoh nyata yang pernah saya lakukan (dan menyesali): ALTER TABLE invoices ADD COLUMN tenant_region text NOT NULL di tabel 40 juta baris. PostgreSQL butuh ACCESS EXCLUSIVE lock untuk itu — selama migrasi berjalan, semua query ke tabel itu menunggu, dan antrean ikutan menggantung aplikasi. Deploy "zero-downtime" jadi downtime 4 menit.
Setelah dua kali kena masalah ini, sekarang saya selalu pecah migrasi breaking menjadi tiga rilis:
- Rilis 1: tambah kolom nullable, isi data secara bertahap (backfill di batch, bukan satu
UPDATEraksasa). - Rilis 2: aplikasi menulis ke kolom baru sambil masih membaca kolom lama.
- Rilis 3: set
NOT NULL(di PostgreSQL modern ini cepat kalau constraint sudah terpenuhi) dan hapus kolom lama.
Prinsip yang saya pegang: di environment blue-green/rolling, skema database harus kompatibel dengan dua versi aplikasi sekaligus. Kalau tidak, strategi deployment secanggih apa pun tidak menolong. Pola expand-migrate-contract ini juga yang saya pakai untuk menghindari jebakan serupa saat merancang skema audit dan soft delete — perubahan skema besar selalu bertahap, tidak pernah satu langkah.
Kasus khusus: SPA dan aset statis
Kalau aplikasi Anda Single Page Application, ada jebakan tambahan: user yang sedang membuka tab lama memuat chunk JavaScript versi lama dari server yang sudah deploy versi baru. Hasilnya error Loading chunk failed saat user navigasi. Diskusi di Stack Overflow tentang zero-downtime deployment SPA merangkum solusinya dengan baik: jangan hapus chunk lama segera (beri grace period), dan tambahkan handler retry yang me-reload halaman saat chunk gagal dimuat. Setelah saya terapkan, komplain "aplikasi kadang blank" hilang.
Untuk arsitektur microservice yang saling memanggil, pertanyaan yang sama dibahas di Zero Downtime Deployment for Micro Service Architecture — intinya sama: kompatibilitas antar-versi dan graceful shutdown adalah dua syarat mutlak, bukan opsi.
Kapan pakai yang mana: keputusan saya
Setelah beberapa tahun mencoba keduanya, ini heuristik yang saya pakai:
- Tim kecil, VPS, aplikasi monolit → blue-green dengan Kamal Proxy atau pola docker-compose. Simpel, rollback instan, dan Anda bisa smoke test environment baru sebelum traffic pindah. Ini setup favorit saya untuk proyek 2–5 engineer.
- Kubernetes/EKS, traffic besar, banyak replica → rolling update dengan
maxUnavailable: 0, PodDisruptionBudget, dan handlerSIGTERMyang benar. Blue-green full di Kubernetes itu boros dan menambah kompleksitas ingress. - Perubahan breaking pada API atau skema → jangan andalkan strategi deployment. Pakai kompatibilitas ke belakang + feature flag, lalu bersihkan versi lama di rilis berikutnya.
- SPA → apapun strateginya, jangan hapus aset lama segera.
Terakhir, satu hal yang lebih penting dari semua strategi di atas: ukur downtime Anda sungguhan. Pasang uptime check dengan interval 10 detik yang menghitung end-to-end (bukan hanya health check internal), dan pantau error rate selama window deploy. Saya kaget waktu pertama kali memasang ini — deploy yang saya kira zero-downtime ternyata punya gap 3–4 detik. Tanpa pengukuran, semua yang saya tulis di atas cuma keyakinan, bukan fakta.
Sumber
- Kamal Proxy – A minimal HTTP proxy for zero-downtime deployments — proxy yang saya pakai untuk blue-green deployment di VPS tanpa Kubernetes
- Zero-Downtime Kubernetes Deployments on AWS with EKS — referensi konfigurasi rolling update dan PodDisruptionBudget
- Zero-Downtime Deployments with Docker Compose – No Kubernetes Required — alternatif blue-green sederhana dengan docker-compose + nginx
- Zero downtime/blue-green deployment of Single Page Application (SPA) — solusi masalah chunk gagal dimuat pada SPA
- Zero Downtime Deployment for Micro Service architecture — kompatibilitas antar-versi di arsitektur microservice
Tomi Hartanto
Senior Software Engineer
Backend developer dengan 8+ tahun pengalaman membangun sistem scalable. Menulis tentang arsitektur backend, database, dan DevOps.
Artikel Terkait
Tomi Hartanto
Senior Software EngineerBackend developer dengan 8+ tahun pengalaman membangun sistem scalable. Menulis tentang arsitektur backend, database, dan DevOps.